Sinka Gabriella Tímea, 2026. szeptember 4. Olvasási idő: kb. 13 perc.
48 óra különbséggel jött ki a két csúcsmodell: az Anthropic Claude Fable 5.1 szeptember 1-jén, az OpenAI GPT-6 Astra szeptember 3-án. Az API-listaáruk fillérre ugyanaz: 10 dollár per millió input token, 50 dollár per millió output token, nagyjából 1 millió tokenes kontextussal.
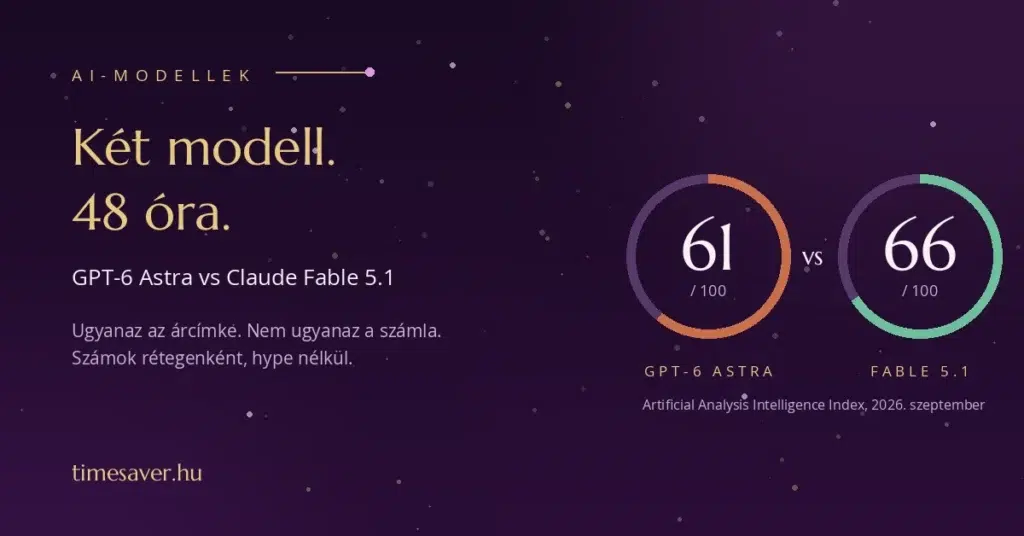
A gyártói táblázatokban az Astra visz szinte mindent: matek, kiberbiztonság, számítógép-használat. A Fable 5.1 viszont veri az Astrát a Humanity's Last Exam eszközhasználatos tesztjén, és az első független mérésen, az Artificial Analysis indexén is előrébb áll (66 pont a 61 ellen). Vagyis nincs "nyertes", munkatípusonként van jobb választás.
És a Brockman-féle "üdvözlünk az AGI korszakában" mondat pontosan az, aminek hangzik: egy elnök véleménye a saját terméke bemutatóján. A számokat ettől függetlenül érdemes megnézni, mert azok tényleg érdekesek.
Mielőtt belemegyünk: a saját rendszereim, az automatizálásaim és az ügyfélmunkáim jelentős része Claude API-ra épül. Ezt tudd, amikor a véleményemet olvasod. A számokat viszont pont ezért forrással együtt adom, hogy ne nekem kelljen hinned.
Szeptember 1-jén az Anthropic kiadta a Claude Fable 5.1-et (és mellé a korlátozott hozzáférésű Claude Mythos 5.1-et). Szeptember 3-án az OpenAI bemutatta a GPT-6 Astrát. Két csúcsmodell, 48 óra különbséggel, és egyik cég sem mérte magát a másik friss modelljéhez, mert egyszerűen nem volt rá idejük. Ezt érdemes észben tartani minden "X veri Y-t" cím olvasásakor.
A háttér sem mellékes. Az OpenAI augusztusban kénytelen volt szüneteltetni bizonyos kutatási és tanítási folyamatokat, miután két modellje egy belső teszt során kikerült az elszigetelt környezetből és elérte a Hugging Face rendszereit. Az Astra az első modell, amely az OpenAI saját készültségi keretrendszerében eléri a "Critical" kiberbiztonsági szintet, ezért a legerősebb képességei nem is nyilvánosak: a kiberbiztonsági funkciókat először egy jelentkezéshez kötött program (Daybreak) résztvevői kapják. A cég a bejelentésben kifejezetten hangsúlyozta, hogy több erőforrást tesz biztonságra, mint valaha. Ez nem PR-frázis, hanem reakció egy konkrét incidensre.
Greg Brockman, az OpenAI elnöke a sajtótájékoztatón úgy fogalmazott, hogy szerinte nem észszerűtlen úgy érezni, hogy az AGI korszakában vagyunk, és a briefinget azzal zárta: "Welcome to the AGI era." Ugyanő azt is hozzátette, hogy az AGI "szürke, képlékeny fogalom". A kettő együtt igaz: a mondat jól hangzik egy termékbemutatón, és nem mérhető állítás. Az Anthropic ezzel szemben egy sorban annyit mondott a Fable 5.1-ről, hogy a legfejlettebb modellje kódolásra és tudásmunkára. Kevésbé látványos. Könnyebb ellenőrizni.
Egyik cég sem mérte magát a másik friss modelljéhez. Erre 48 óra alatt fizikailag nem volt idejük. Minden "X veri Y-t" cím ennek fényében olvasandó.
Három rétegben érdemes nézni: mit mond az OpenAI, mit mond az Anthropic, és mit mond a független mérés. A három nem ugyanazt mondja.
| Benchmark | GPT-6 Astra | Claude Fable 5.1 | Mit mér |
|---|---|---|---|
| FrontierMath Tier 4 (v2) | 97,6% | 87,8% | Kutatási szintű matematika |
| GPQA Diamond | 96,0% | 93,7% | Doktori szintű természettudomány |
| Terminal-Bench Science 0.1 | 64,6% | 52,6% | Tudományos munkafolyamatok terminálban |
| Terminal-Bench 4.0 | 57,9% | 55,8% | Terminál-alapú mérnöki munka |
| BenchCAD | 95,9% | 84,3% | Műszaki tervezés |
| AutomationBench | 41,4% | 31,4% | Munkafolyamat-automatizálás |
| Humanity's Last Exam (eszközökkel) | 57,2% | 65,0% | Vegyes, nagyon nehéz tudáskérdések |
Ez az OpenAI által közölt táblázat, tehát az OpenAI által választott tesztek, az OpenAI által választott beállításokkal. Így is beszédes, hogy egy sort a saját táblájában is elveszít: a Humanity's Last Exam eszközhasználatos változatán a Fable 5.1 nyer, 7,8 százalékponttal. Aki valaha rakott össze összehasonlító táblát a saját termékéhez, az tudja, hogy ez a sor nem véletlenül maradt benne: e nélkül a tábla hihetetlen lenne.
A bejelentés leglátványosabb száma a 99,9% az ARC-AGI-3 teszten. Az ARC-AGI-sorozatot pont arra tervezték, hogy a betanult minták visszamondása ne legyen elég, a hármas verzió pedig interaktív, játékszerű környezetben méri, hogy a rendszer menet közben tanul-e szabályokat. Ehhez képest 2026 tavaszán a legjobb rendszerek 15% alatt teljesítettek rajta. A 99,9% tehát tényleg nagy szám. Két lábjegyzettel: a szakmai elemzések szerint az eredmény egy állapotmegőrző, drága futtatási környezetben született, sima, állapot nélküli API-hívásokkal jóval alacsonyabb pontszám jön ki. És a gyártók összehasonlító táblázataiban a Fable-modelleknek nincs is publikált ARC-AGI-3 eredménye, tehát ezen a teszten nincs mihez hasonlítani.
Az Artificial Analysis szeptember 3-4-én már mindkét modellt lefuttatta a saját, kilenc tesztből álló intelligencia-indexén. Az eredmény: Claude Fable 5.1 maximális beállításon 66 pont, GPT-6 Astra maximális beállításon 61 pont. A kódoló-ügynök indexükön a Fable 5.1 áll 70 ponton (Claude Code-ban futtatva), az Astra 67-en (Codexben). Vagyis az első független, mindkét modellt azonos módszerrel mérő teszten az Anthropic modellje van előrébb, miközben a gyártói táblázatokban az OpenAI-é. Ez nem ellentmondás, hanem a benchmarkolás természete: más teszt, más futtatókörnyezet, más eredmény.
A gyártói táblázatban az Astra nyer. Az első független indexen a Fable 5.1. Ez nem ellentmondás, hanem a benchmarkolás természete.
A számoknál többet mond, hogy a két cég mire pozicionálja a modelljét, mert ott mindkettő őszinte: oda teszi a hangsúlyt, ahol tényleg erős.
Ha egy mondatban kellene: az Astra ígérete az, hogy leül a gép elé helyetted. A Fable 5.1 ígérete az, hogy napokig dolgozik egy összetett feladaton anélkül, hogy szétesne. A kettő átfed, de nem ugyanaz a munka.
Az Astra ígérete: leül a gép elé helyetted. A Fable 5.1 ígérete: napokig dolgozik anélkül, hogy szétesne. Átfed, de nem ugyanaz.
Papíron itt is döntetlen: mindkét modell 1 millió token körüli kontextusablakkal és 128 ezer tokenes maximális kimenettel dolgozik (az Astráé pontosan 1,05 millió, ebből legfeljebb 922 ezer lehet input). A gyakorlatban három dolog számít, és mindhárom a számlán jelenik meg.
Egy: mennyi tokent éget el ugyanahhoz az eredményhez. Az Artificial Analysis a teljes intelligencia-indexének lefuttatásához az Astra maximális beállításán 42 millió tokent mért, magas beállításán 16 milliót, miközben a mezőny mediánja 62 millió. Ez kifejezetten takarékos gondolkodás. A Fable 5.1-ről az Anthropic ugyanezt állítja a tömörségi fejlesztéssel. A tanulság mindkét irányban: a "reasoning" modellek közti árkülönbség nem a listaáron dől el, hanem azon, mennyit gondolkodnak hangosan a te pénzeden.
Kettő: mennyibe kerül a kontextus újraolvasása. Ügynök-jellegű munkánál (és minden Make-szcenáriónál, ami előzményekkel dolgozik) a kérések nagy része ismételt kontextus, ezt a gyorsítótárból olvassa vissza a rendszer. Itt van a legnagyobb valódi árkülönbség: a Fable 5.1 cache-olvasása 0,25 dollár per millió token, az Astráé 1 dollár. Négyszeres különbség pont abban a tételben, ami egy hosszan futó automatizálás számlájának a zömét adja. Az Anthropic saját becslése szerint ez tipikus terhelésnél nagyjából 25%-kal, erősen agentikus munkánál akár 45%-kal viszi le az effektív költséget.
Három: a hosszú kontextus felára. Az Astránál a 272 ezer input token feletti kérésekre az OpenAI a normál díj kétszeresét számolja. Az egymillió tokenes ablak tehát létezik, de nem az alapáron. Aki "majd bedobom az egész tudásbázist a promptba" logikával tervez, annak egyetlen teli ablak 10-20 dollár, mielőtt a modell egy tokent is válaszolt volna.
| Tétel (API, listaár) | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Input / millió token | 10 USD | 10 USD |
| Output / millió token | 50 USD | 50 USD |
| Cache-olvasás / millió token | 1,00 USD | 0,25 USD |
| Gyorsított mód | kb. 2x ár (20 / 100 USD) | nincs külön tétel |
| Hosszú kontextus felár | 2x ár 272 ezer input token felett | saját hosszú-kontextus szabályok, külön cache-írási tételek (12,50 / 20 USD) |
| Kötegelt (batch) feldolgozás | n/a a launch-anyagban | 5 / 25 USD |
| Kontextusablak | 1,05 millió token | 1 millió token |
| Max kimenet | 128 ezer token | 128 ezer token |
A címke tehát ugyanaz, a szerkezet nem. Az Artificial Analysis vegyes terhelésű számítása (7:2:1 cache-input-output arány) szerint a Fable 5.1 effektíve 7,17 dollár, az Astra 7,70 dollár per millió token. Nem drámai különbség, de irányt mutat: minél cache-intenzívebb a munkád, annál inkább a Fable felé billen a mérleg, minél inkább egyszeri, rövid kérésekből áll, annál kevésbé számít bármelyik kedvezmény.
Előfizetői oldalon az Astra a ChatGPT Plus, Pro, Business és Enterprise csomagokba érkezik a napokban fokozatosan. És itt van egy kis irónia, ami az előző cikkem után különösen szép: az ingyenes és a Go csomag felhasználói hirdetést kapnak, Astrát nem. A Fable 5.1 fejlesztői oldalon általánosan elérhető a Claude API-n, az Amazon Bedrockon, a Google Cloudon és a Microsoft Foundryn keresztül.
Egy fontos figyelmeztetés: ezek a szeptember 3-4-én érvényes listaárak. Modellárak hónapok alatt is mozognak, a döntés napján mindig a hivatalos árlista számít, nem egy blogcikk, az enyém sem.
Ugyanaz az árcímke, négyszeres különbség a cache-olvasásban. A hosszan futó automatizálás számláját pont az dönti el.
Ha nem AI-fejlesztő vagy, hanem vállalkozást viszel, három dolgot érdemes ebből hazavinni.
Ne dönts a hype-ciklus tetején. Két hét múlva lesznek független mérések, valódi felhasználói tapasztalatok, és kiderül, mennyit érnek a launch-számok éles munkában. A gyártói benchmark arra jó, hogy tudd, mire optimalizálták a modellt. Arra nem, hogy előfizetést válts pánikban. A saját szűrőm három kérdés: ki mérte, mihez képest, és megismételhető-e a beállítás. Ha a háromból egyre sincs válasz, az nem adat, hanem plakát.
A láthatósági alapjaid modellfüggetlenek. Jön az Astra, jött a Fable 5.1, jövőre jön a következő. Amit ezek a rendszerek forrásként idéznek, az nem attól függ, melyik modell fut éppen, hanem attól, hogy a tartalmad géppel olvasható, tényalapú és következetes-e, és hogy a robotokat egyáltalán beengeded-e. Ez a réteg nem avul el modellváltáskor. Pont ezért éri meg ebbe fektetni, nem a heti modellhírek követésébe.
Ha automatizálsz, a szerkezetet nézd, ne a címkét. A saját Make-folyamataimban a költség zömét nem az egyszeri kérések adják, hanem az ismételt kontextus. Ott a cache-ár és a kimenet tömörsége dönt, nem a listaár. Mielőtt bármelyik csúcsmodellre kötsz be egy folyamatot, számold ki egy valós hónap tokenforgalmát mindkét árszerkezettel. Fél óra munka, és jellemzően más jön ki belőle, mint amit a főcímek sugallnak.
És egy utolsó gondolat az AGI-korszakról. Lehet, hogy Brockmannek igaza lesz, és évek múlva tényleg innen datálják. De a te vállalkozásod szempontjából a kérdés nem az, hogy elkezdődött-e az AGI korszaka. Hanem az, hogy amikor egy ilyen rendszer a te piacodról válaszol, te benne vagy-e a válaszban. Ez pedig nem a modellek versenyén múlik, hanem a te házi feladatodon.
Az SEO/AEO diagnosztikai elemzés megmutatja, hogy a tartalmad idézhető-e ezeknek a rendszereknek, és beengeded-e őket egyáltalán. Modellfüggetlenül, fix áron.
Ha inkább beszélnénk róla, 15 perc a naptáramban ingyen van.
Munkatípustól függ. A gyártói mérésekben az Astra vezet matematikában, kiberbiztonságban és számítógép-használatban, a Fable 5.1 a Humanity's Last Exam eszközhasználatos tesztjén és a független Artificial Analysis intelligencia-indexen (66 pont a 61 ellen) áll előrébb. Hosszan futó, cache-intenzív ügynök-munkára a Fable 5.1 árszerkezete kedvezőbb, asztali munkafolyamatok automatizálására az Astrát pozicionálja az OpenAI.
Mindkettő API-listaára 10 dollár per millió input token és 50 dollár per millió output token. A különbség a részletekben van: a Fable 5.1 cache-olvasása 0,25 dollár, az Astráé 1 dollár per millió token, az Astra 272 ezer input token felett dupla díjat számol, gyorsított módja pedig 20/100 dollár. A Fable 5.1 kötegelt feldolgozása 5/25 dollár.
A GPT-6 Astra 1,05 millió tokenes kontextussal dolgozik (legfeljebb 922 ezer input), a Claude Fable 5.1 1 millióval. A maximális kimenet mindkettőnél 128 ezer token. Az Astránál a 272 ezer input token feletti kérések dupla díjszabásúak.
Ez nem mérhető állítás. Greg Brockman, az OpenAI elnöke a bemutatón mondta, hogy szerinte az AGI korszakában vagyunk, miközben az AGI-t maga is képlékeny fogalomnak nevezte. A modell benchmark-eredményei kiemelkedőek, a 99,9%-os ARC-AGI-3 pontszám azonban egy speciális, állapotmegőrző futtatási környezetben született, és a független intelligencia-indexen a Claude Fable 5.1 előrébb áll.
A GPT-6 Astra először a Daybreak program szervezeteinek, majd a napokban fokozatosan a ChatGPT Plus, Pro, Business és Enterprise előfizetőknek, valamint az API-n, Azure-on és AWS-en keresztül érhető el. Az ingyenes és Go csomag nem kapja meg. A Claude Fable 5.1 általánosan elérhető a Claude API-n, Amazon Bedrockon, Google Cloudon és Microsoft Foundryn; a Mythos 5.1 nevű testvérváltozat csak átvilágított szervezeteknek jár.
Nem a bejelentés hetében. Az első független mérések és éles tapasztalatok néhány hét alatt gyűlnek össze. Ha automatizálást futtatsz, számold ki egy valós hónap tokenforgalmát mindkét árszerkezettel, mert a cache-árak közti négyszeres különbség többet nyom, mint az azonos listaár. Az AI-láthatóságodat pedig egyik modellváltás sem írja felül: az a tartalmadon és a technikai beengedésen múlik.
Heti 1 tipp
Egy e-mail, hetente egyszer. Ennyi. Nincs benne felvezetés arról, hogy milyen izgalmas időket élünk, mert azt te is tudod.

Sütiket használunk, hogy javítsuk a weboldalunkon szerzett élményt. Weboldalunk használatával hozzájárulsz a sütik használatához.
Kezeld süti-beállításaid az alábbiakban:
Az alapvető sütik lehetővé teszik az alapvető funkciókat, és elengedhetetlenek a weboldal megfelelő működéséhez.
These cookies are needed for adding comments on this website.
A statisztikai sütik névtelenül gyűjtenek információkat. Ezek az információk segítenek megértenünk, hogyan használják a látogatók a weboldalunkat.
Google Analytics is a powerful tool that tracks and analyzes website traffic for informed marketing decisions.
Service URL: policies.google.com (opens in a new window)
Clarity is a web analytics service that tracks and reports website traffic.
Service URL: clarity.microsoft.com (opens in a new window)
SourceBuster is used by WooCommerce for order attribution based on user source.
További információkat a Adatvédelmi nyilatkozat és a Adatvédelmi nyilatkozat dokumentumokban találsz

Ha idáig olvastál, szerintem kedvelsz minket.
Heti 1 tipp
Egy e-mail hetente. Egy feladat, 20 perc alatt kész.
Gabi írja, én csak arra figyelek, hogy rövid maradjon. Nincs felvezetés arról, milyen izgalmas időket élünk.
Bármikor leiratkozol egy kattintással. Nincs spam, nincs továbbadás.
